Phương pháp điều khiển học tăng cường của hệ thống phanh tái sinh trên ô tô điện
- Thứ ba - 27/10/2026 16:17
- In ra
- Đóng cửa sổ này
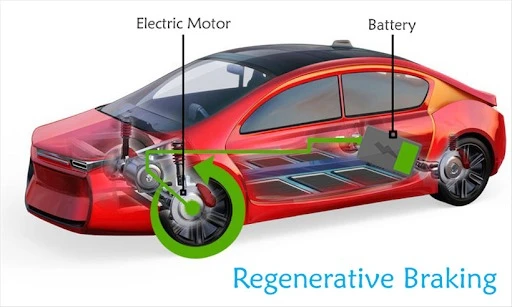
Hệ thống phanh tái sinh (Regenerative Braking System - RBS) trên ô tô điện đóng vai trò cốt lõi trong việc thu hồi động năng dư thừa trong quá trình xe giảm tốc độ hoặc xuống dốc để chuyển hóa thành điện năng nạp ngược trở lại cho bộ pin cao áp. Thách thức kỹ thuật lớn nhất trong việc điều khiển hệ thống này là giải quyết bài toán tối ưu hóa đa mục tiêu: vừa phải tối đa hóa hiệu suất thu hồi năng lượng nhằm mở rộng quãng đường di chuyển của phương tiện sau mỗi chu kỳ sạc, vừa phải phối hợp nhịp nhàng giữa mô-men phanh tái sinh từ mô-tơ điện và mô-men phanh ma sát thủy lực cơ khí để đảm bảo an toàn chủ động, duy trì tính ổn định động lực học thân xe theo các tiêu chuẩn quốc tế nghiêm ngặt như ECE R13-H, đồng thời giữ vững cảm giác bàn đạp phanh mượt mà, chân thực cho người điều khiển. Các chiến lược điều khiển truyền thống dựa trên tập luật cố định (rule-based), đồ thị tra cứu kinh nghiệm (lookup tables) hoặc logic mờ thích nghi (fuzzy logic) thường bộc lộ những hạn chế đáng kể khi điều kiện vận hành thay đổi liên tục, mặt đường trơn trượt bất định hoặc các đặc tính phi tuyến của pin biến thiên theo thời gian và nhiệt độ. Trong bối cảnh đó, phương pháp học tăng cường (Reinforcement Learning - RL) và đặc biệt là học tăng cường sâu (Deep Reinforcement Learning - DRL) nổi lên như một hướng tiếp cận đột phá, trao cho bộ điều khiển trung tâm (VCU) khả năng tự học, thích ứng linh hoạt và liên tục tìm kiếm chính sách điều khiển tối ưu thông qua quá trình tương tác thực nghiệm với môi trường xe và phong cách của người lái.
Bản chất của việc áp dụng học tăng cường trong bài toán phanh tái sinh là mô hình hóa quá trình phân bổ mô-men phanh thành một quá trình quyết định Markov (Markov Decision Process - MDP), bao gồm cấu trúc bốn thành phần cơ bản: Không gian trạng thái, Không gian hành động, Hàm phần thưởng và Xác suất chuyển trạng thái. Không gian trạng thái của hệ thống bao gồm các thông số động lực học xe và trạng thái thiết bị được thu thập từ mạng truyền thông CAN hoặc CAN-FD theo thời gian thực: vận tốc dọc của xe, gia tốc dọc, vị trí và tốc độ dịch chuyển của bàn đạp phanh, góc quay vô-lăng, gia tốc ngang, hệ số bám ước lượng của mặt đường, cùng các thông số điện hóa của bộ pin như trạng thái sạc (SOC), nhiệt độ cell pin và công suất tiếp nhận sạc cực đại khả dụng. Không gian hành động liên tục xác định tỷ lệ phân chia tổng mô-men phanh giữa trục trước và trục sau, cũng như tỷ lệ điều tiết giữa mô-men phanh tái sinh do máy điện sinh ra và mô-men phanh ma sát cơ học tại từng cụm phanh đĩa bánh xe. Trọng tâm quyết định tính hiệu quả của thuật toán nằm ở thiết kế hàm phần thưởng: hàm này được xây dựng dưới dạng tổ hợp tuyến tính có trọng số, tích cực thưởng cho lượng điện năng tái sinh thu hồi nạp thành công vào pin, đồng thời áp đặt các mức phạt nghiêm khắc đối với hiện tượng trượt lốp quá mức, sai số vận tốc góc quay thân xe (yaw rate) nhằm giữ ổn định hướng lái, và phạt độ biến thiên gia tốc (jerk) nhằm triệt tiêu cảm giác giật cục, đảm bảo độ êm dịu chuyển động cho toàn bộ hành khách.
Để giải quyết triệt để tính phi tuyến phức tạp trong không gian trạng thái và hành động liên tục của phương tiện cơ giới, các kiến trúc học tăng cường sâu hiện đại như Deep Deterministic Policy Gradient (DDPG), Soft Actor-Critic (SAC) và Proximal Policy Optimization (PPO) đã được triển khai hiệu quả. Trong cấu trúc mạng nơ-ron này, mạng Diễn viên (Actor) chịu trách nhiệm ánh xạ trực tiếp các véc-tơ trạng thái đo lường từ cảm biến thành tín hiệu lệnh điều khiển mô-men phanh liên tục một cách mượt mà, trong khi mạng Phê bình (Critic) ước lượng giá trị kỳ vọng của phần thưởng tích lũy trong tương lai để định hướng cho mạng Actor cập nhật trọng số. Ưu thế vượt trội của các thuật toán hiện đại, tiêu biểu như thuật toán SAC, nằm ở cơ chế tối đa hóa độ hỗn loạn (maximum entropy reinforcement learning), khuyến khích tác tử tự do khám phá nhiều chiến lược phân bổ mô-men khác nhau trong các tình huống vận hành phức tạp, tránh rơi vào các điểm cực tiểu cục bộ và nâng cao tính bền vững trước các tín hiệu nhiễu ngẫu nhiên từ cảm biến đo. Khi xe di chuyển trên các cung đường có hệ số bám thay đổi đột ngột (như chuyển từ đường nhựa khô ráo sang vũng nước sâu hoặc mặt đường đóng băng trơn trượt), bộ điều khiển học tăng cường sâu có thể phát hiện tức thời xu hướng bó cứng bánh xe để chủ động cắt giảm mô-men phanh tái sinh, phối hợp kích hoạt hệ thống chống bó cứng phanh (ABS) can thiệp kịp thời, ngăn chặn hoàn toàn hiện tượng văng đuôi xe hoặc mất lái mà các thuật toán cổ điển thường phản ứng chậm trễ.
Quy trình ứng dụng thực tế của bộ điều khiển phanh tái sinh dựa trên học tăng cường đòi hỏi các giai đoạn huấn luyện và kiểm thử khắt khe từ môi trường ảo sang phần cứng thực nghiệm (Sim-to-Real transfer). Ở giai đoạn mô phỏng ban đầu, tác tử học tăng cường được huấn luyện qua hàng triệu bước thời gian trên các chu trình thử nghiệm tiêu chuẩn như WLTC, NEDC hay FTP-75 trong các phần mềm mô phỏng động lực học xe chính xác cao như MATLAB/Simulink, CarSim hoặc IPG CarMaker, kết hợp cùng kỹ thuật ngẫu nhiên hóa miền tham số (domain randomization) để mô hình có khả năng thích ứng vững vàng trước sự biến đổi về tải trọng xe, độ mòn của má phanh cơ khí hay sự suy giảm dung lượng pin theo thời gian. Sau khi đạt được sự hội tụ tối ưu, mạng nơ-ron được nén và lượng tử hóa để nạp vào bộ điều khiển nhúng thời gian thực thông qua thử nghiệm phần cứng trong vòng lặp (Hardware-in-the-Loop - HIL), phối hợp trực tiếp với hệ thống phanh thủy lực điện tử tích hợp (Electro-Hydraulic Brake - EHB) và bộ biến tần điều khiển động cơ điện kéo. Các kết quả đo đạc thực nghiệm cho thấy hệ thống phanh tái sinh ứng dụng học tăng cường có thể gia tăng hiệu suất thu hồi năng lượng thêm từ 8% đến 15% so với các phương pháp phân bổ tỷ lệ cố định truyền thống, đồng thời triệt tiêu độ trễ chuyển tiếp giữa các trạng thái phanh, đem lại cảm giác chân phanh đồng nhất, tuyến tính và bảo đảm an toàn chủ động tối đa cho xe điện trong mọi điều kiện vận hành.